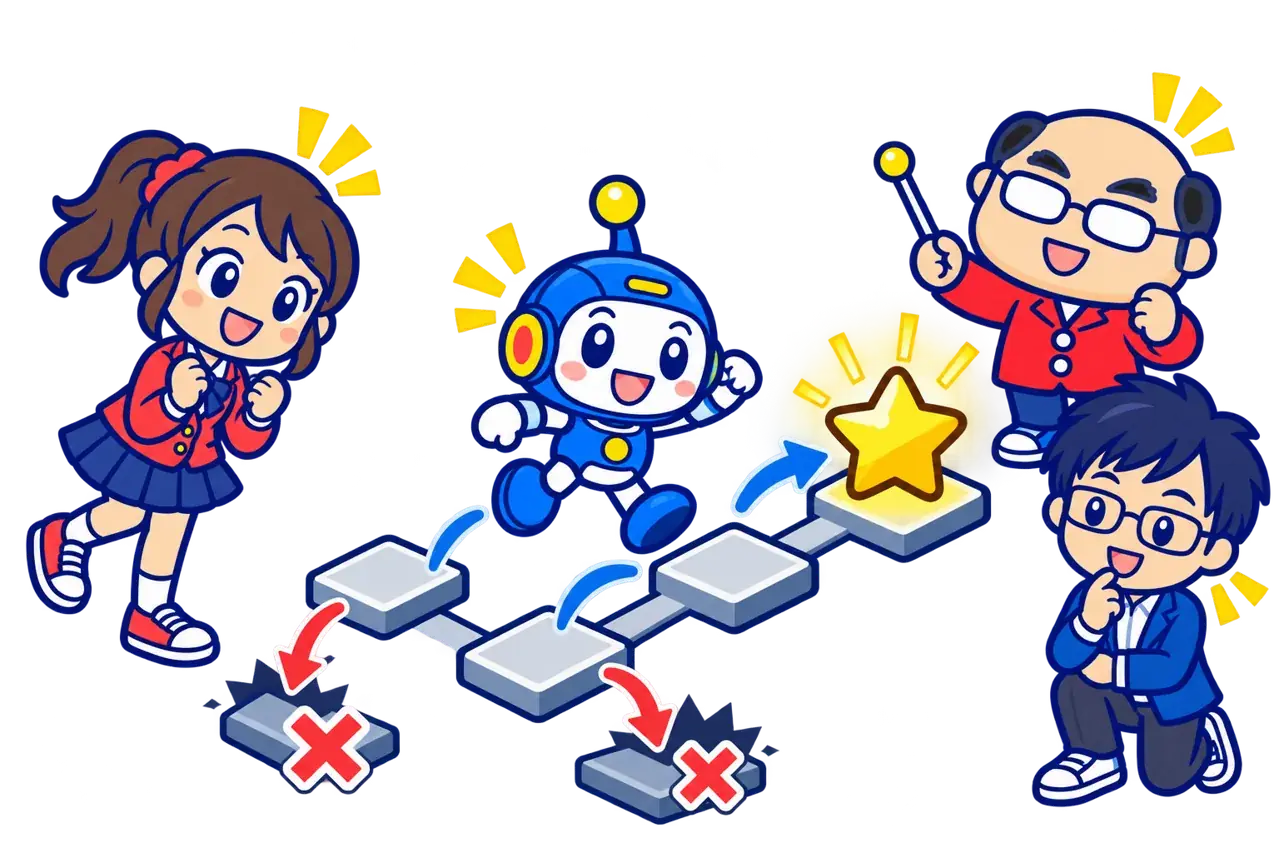
この回でつかむこと
状態・行動・報酬と、探索をする理由を具体例で説明できる。
試しながら学ぶ強化学習って何だろう?
強化学習は、行動する主体(エージェント)が環境の状態を見て行動を選び、得た報酬を手掛かりに行動の方針を学ぶ方法です。ここでは4マスの小さな道を使います。正解の行動を毎回教える教師あり学習とは学び方が違います。
ROBORONは、最初からゴールまでの道を全部知っているの?
いい質問だね。強化学習では、行動して得られた結果を手掛かりに、次はどちらへ進むか学ぶんだよ。最初は試すことも大切なんだ。
状態・行動・報酬を分けて記録すると、何を学習しているか確認できますね。

ROBORON ピコン! 右へ進んでごほうびを得た経験を次に生かすよ。
迷路で行動を選び、報酬から次の選び方を少しずつ変える。 強化学習は、行動する主体(エージェント)が環境の状態を見て行動を選び、得た報酬を手掛かりに行動の方針を学ぶ方法です。ここでは4マスの小さな道を使います。正解の行動を毎回教える教師あり学習とは学び方が違います。
import numpy as np
positions = np.arange(4)
rewards = np.array([0, 0, 0, 1])
print('位置:', positions)
print('ゴールの報酬:', rewards[-1])なぜそうなる? ROBORONは位置0から出発します。位置3がゴールです。途中の報酬は0で、最後だけ1を受け取ります。
行動の価値を少しずつ更新する
Q値は、ある位置である行動を選ぶ良さの見積もりです。ゴールへ近づく行動が高く評価されるか、Colabで試します。
q = np.zeros((4, 2))  # 各位置で、左・右の2行動
state, action, reward, next_state = 2, 1, 1, 3
q[state, action] += 0.5 * (reward + 0.9 * q[next_state].max() - q[state, action])
print(q[2])ここに注目 位置2で右を選び、ゴールへ着いた経験から、右のQ値が0から0.5へ上がります。左の値はまだ0です。
予想して、理由を話そう
答えを選んで、説明を確かめよう。外れても発見が一つ増えるよ。
答えを選ぶと理由が表示されます。
Colabで試してみよう
コードの実行はColaboratoryの実行環境で行います。まずノートブックを保存し、Colabで「ファイル → ノートブックをアップロード」から開いてください。上から順に実行し、最後に値を変えてみましょう。
保存ボタンを押しても画面は切り替わりません。通常はブラウザの「ダウンロード」フォルダに .ipynb が保存されます。見つからない場合はダウンロード履歴を確認してください。Colabの実習は小さな例から始められます。
身近な技術とつなげてみよう
AI先生:ゲームの迷路だけでなく、ロボット制御にもつながる考え方だよ。ただし現実のロボットは安全に試せる範囲を決めてから学習させるんだ。
この回の重要な用語
本文で出会った言葉を、ここで意味と一緒に振り返ろう。上の「ことばの窓」からも説明を開けるよ。
- 強化学習
- 行動の結果として得られる報酬を手掛かりに、行動の方針を学ぶ方法です。
- エージェント
- 環境の中で行動を選ぶ主体です。この例ではROBORONです。
- 状態
- 行動を選ぶときに見えている環境の情報です。この例では現在位置です。
- 報酬
- 行動の結果に対する数値の手掛かりです。目的に合う行動を学ぶために使います。
- Q値
- ある状態である行動を選ぶ価値の見積もりです。
- Q学習
- Q-learning。行動して得た報酬から、各状態と行動のQ値を更新する強化学習の方法です。
- 探索
- 今わかっている最善だけに頼らず、別の行動も試すことです。