この回でつかむこと
過学習を見つけ、2つの手法の違いを言える。
覚えすぎを防ぐって何だろう?
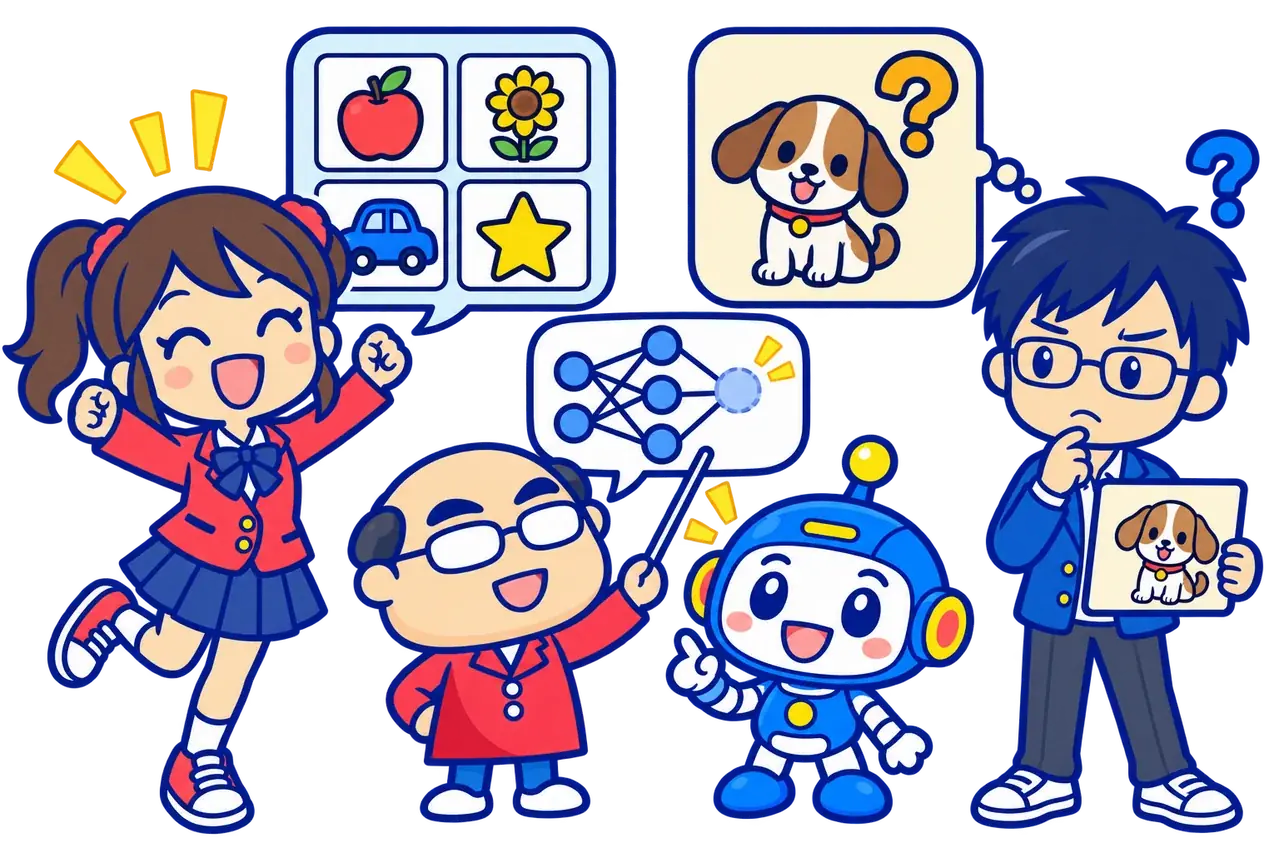
過学習は学習用データに合わせすぎた状態です。Dropoutは学習中に一部の値をランダムに0にして、特定の経路に頼りすぎないようにします。PyTorchのpは0にする確率です。
練習問題は満点! でも初めての問題は外しちゃった。
それが『覚えすぎ』かもしれないね。学習用と検証用を別々に見よう。
Dropoutは学習中に一部の値を0にし、BatchNormは途中の値を整える。役割が違うのですね。

AI先生 練習では得意でも、初めての問題ではどうか確かめようね。
訓練精度だけでは、未知のデータでの性能は分からない。 過学習は学習用データに合わせすぎた状態です。Dropoutは学習中に一部の値をランダムに0にして、特定の経路に頼りすぎないようにします。PyTorchのpは0にする確率です。
import torch
from torch import nn
torch.manual_seed(3)
drop = nn.Dropout(p=0.5)
x = torch.ones(8)
print(drop(x))
drop.eval(); print(drop(x))なぜそうなる? 学習時の残った値は期待値を保つよう調整されます。評価時はDropoutを止めます。
BatchNormは何を調整する?
Batch Normalizationはバッチの統計を使って中間の値を整えます。学習時と評価時で使う統計が異なるため、評価前にeval()へ切り替えます。
bn = nn.BatchNorm1d(2)
bn.train(); print(bn(torch.tensor([[1.,3.],[3.,5.]])).shape)
bn.eval(); print(bn(torch.tensor([[2.,4.]])).shape)ここに注目 BatchNormは出力の形を変えません。Dropoutと同じ操作ではありません。
予想して、理由を話そう
答えを選んで、説明を確かめよう。外れても発見が一つ増えるよ。
答えを選ぶと理由が表示されます。
Colabで試してみよう
コードの実行はColaboratoryの実行環境で行います。まずノートブックを保存し、Colabで「ファイル → ノートブックをアップロード」から開いてください。上から順に実行し、最後に値を変えてみましょう。
保存ボタンを押しても画面は切り替わりません。通常はブラウザの「ダウンロード」フォルダに .ipynb が保存されます。見つからない場合はダウンロード履歴を確認してください。Colabの実習は小さな例から始められます。
身近な技術とつなげてみよう
AI先生:模擬試験の答えだけ暗記しても、初めての問題で困るよね。モデルにも同じ確認が必要なんだ。
この回の重要な用語
本文で出会った言葉を、ここで意味と一緒に振り返ろう。上の「ことばの窓」からも説明を開けるよ。
- 過学習
- 学習データには合うのに、未知のデータではうまくいかない状態です。
- Dropout
- 学習中に一部の値をランダムに0にする手法です。
- BatchNorm
- Batch Normalization。中間の値をバッチ統計で整える層です。
- 検証用データ
- 学習の進み方や設定を確認するため、重み更新には使わないデータです。