この回でつかむこと
1件・1バッチ・1エポックの違いを言える。
データを小分けにして学ぶって何だろう?
Datasetは入力と正解の組を1件ずつ扱い、DataLoaderは指定したバッチサイズで取り出します。全データを一通り見たら1エポックです。
全部いっぺんに運ぶと、ROBORONの腕がいっぱい!
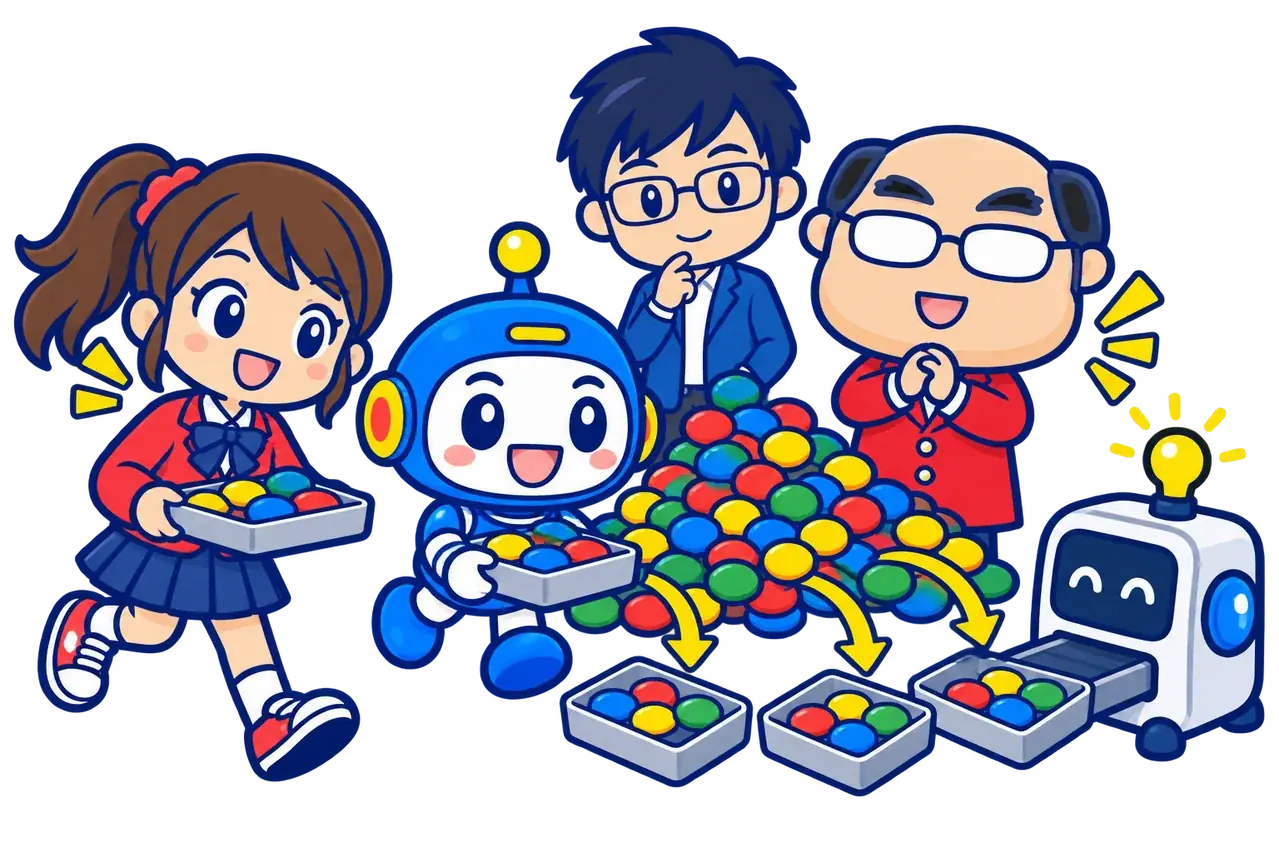
いい例えだね。小分けの箱を順番に運ぶのがミニバッチなんだよ。
1回の更新で使う件数がバッチサイズですね。

あおい 最後の2件もちゃんと入ってる! 置き忘れずにすんだね。
10件を4件ずつなら、4・4・2件の3バッチになる。 Datasetは入力と正解の組を1件ずつ扱い、DataLoaderは指定したバッチサイズで取り出します。全データを一通り見たら1エポックです。
import torch
from torch.utils.data import TensorDataset,DataLoader
x = torch.arange(10).float().unsqueeze(1)
y = x*2
loader = DataLoader(TensorDataset(x,y),batch_size=4,shuffle=False)
print([len(a) for a,b in loader])なぜそうなる? 最後の2件も落とさずに使う設定です。
順番を混ぜる理由
学習用では順番を混ぜることがあります。ただし、時系列予測では窓の作り方や分割順を先に考えます。
print(len(loader.dataset))
print(len(loader))ここに注目 datasetの長さは件数、loaderの長さはバッチ数です。
予想して、理由を話そう
答えを選んで、説明を確かめよう。外れても発見が一つ増えるよ。
答えを選ぶと理由が表示されます。
Colabで試してみよう
コードの実行はColaboratoryの実行環境で行います。まずノートブックを保存し、Colabで「ファイル → ノートブックをアップロード」から開いてください。上から順に実行し、最後に値を変えてみましょう。
保存ボタンを押しても画面は切り替わりません。通常はブラウザの「ダウンロード」フォルダに .ipynb が保存されます。見つからない場合はダウンロード履歴を確認してください。Colabの実習は小さな例から始められます。
身近な技術とつなげてみよう
AI先生:給食を10人分、4人ずつ運ぶと3往復。最後の2人分も忘れないでね。
この回の重要な用語
本文で出会った言葉を、ここで意味と一緒に振り返ろう。上の「ことばの窓」からも説明を開けるよ。
- Dataset
- 入力と正解を1件ずつ取り出せるデータのまとまりです。
- DataLoader
- Datasetをバッチにして順番に渡す道具です。
- ミニバッチ
- 全件より少ない数を一度の更新で使う単位です。
- エポック
- 学習用データ全体を一巡することです。